字节Seed发现DeepSeek抽风原因
字节Seed发现DeepSeek抽风原因
你昨天给 DeepSeek 发了一段 50 页的合同,它回答到第三个问题时突然"忘了"。
不是它不知道——合同前 12 页写得清清楚楚。但你把同样的问题换个位置再问一次,它又能答上来。再换回去,又答错了。你以为是网络问题,刷新一下;以为是 prompt 写得不够清楚,又改了一遍。你揉了揉眼睛,心想"是不是我升级到 Pro 会被分配到比较差的节点"。
那秒让你真正不舒服的不是 AI 答错——而是它理论上完全应该答对,却在你最需要它的时候周期性失忆。
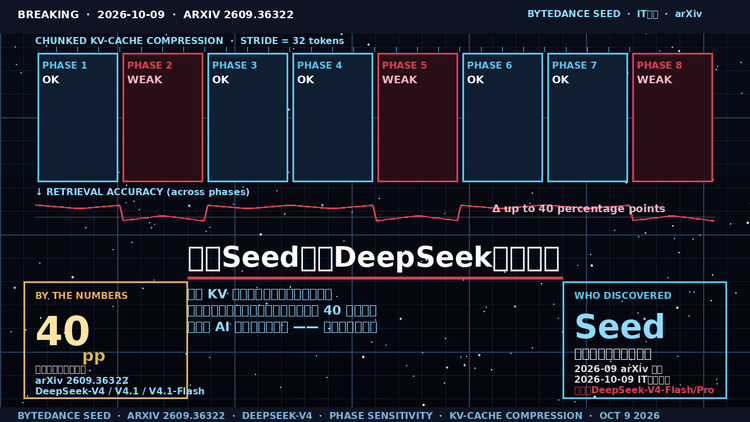
10 月 9 日,IT 之家转载了一条来自 arXiv 的预印本论文:字节跳动 Seed 团队用一篇标题叫《Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression》的研究,正式指出 DeepSeek"抽风"不是你的问题,是分块 KV 缓存压缩(chunked KV-cache compression)这个机制本身的"系统性相位敏感性"(phase sensitivity)——同一个信息在不同相位,检索准确率能差 40 个百分点。
这不是单一 bug 修复,而是一种"你怎么也绕不过去"的底层机制代价。读懂它,你才能理解——为什么你最近用 DeepSeek、Kimi、豆包这类长上下文模型时,总觉得"它知道但就是答错"。
一、什么是"分块 KV 缓存压缩"
要理解这篇论文说了什么,先要理解大模型今天是怎么"省内存"的。
任何一个跑过大模型推理的人都知道,KV 缓存(KV cache) 是推理时最大的内存开销——它要记住你前面每一句话的"键"和"值",才能在生成下一句话时"回头看"。你的上下文越长,它就越胖。
为了让你用得起长上下文,模型厂商普遍做了一件事:把连续的一段 token 压成一个"摘要",每隔固定步幅(stride)压缩一次。这叫 chunked KV-cache compression。
DeepSeek-V4、V4.1 都用了这个机制。论文里直接点名:"A practical remedy, used in models such as DeepSeek-V4 [11], is chunked KV-cache compression: the model groups consecutive tokens into fixed-size windows, compresses each window into fewer cache entries, and uses these summaries for long-context retrieval."
翻译成人话:
- 把 32 个 token 压成 4 个 token 的摘要;
- 每隔 32 个 token 再压一组;
- 推理时只看摘要,不再读原始 token。
代价便宜了 8 倍。但压缩是按"位置"切窗口的——这就引入了一个新坐标:每个 token 的**"相位"(phase)**,即它相对于压缩窗口边界的位置。
二、字节 Seed 到底发现了什么
论文的核心发现可以一句话概括:
在使用 chunked KV-cache 压缩的模型中,同一段信息的检索准确率,取决于它落在哪个相位。某些相位"幸运",检索准确率 90% 以上;某些相位"倒霉",可能掉到 50% 以下。
更具体地说:
- DeepSeek-V4、V4.1 以及他们从零预训练的所有 chunked 压缩模型,全部复现了这个现象。这不是某一个模型的工程 bug,是 chunked 压缩机制本身的系统性副作用。
- 相位之间的检索准确率差异,可以高达 40 个百分点。论文原话:"long-context retrieval accuracy can differ by up to 40 percentage points across phases"。
- 这个周期性是按压缩步幅来的——也就是说,32 token 一组,你的 token 落在 32 的整数倍位置附近还是不在,差别是结构性的。
- 平均基准分数会掩盖这一点——论文警告:"average benchmark scores can conceal periodic weak spots"。也就是说,模型在整体跑分上看着 95 分没问题,但你的某段内容就是会落在那个 50 分的相位里,你没法靠"看平均分"判断。
- 机制分析:研究者做了因果干预实验,发现不同注意力组件在不同相位贡献了不对称的检索能力——他们把这个叫"相位专精化(phase specialization)"。简单说:模型在某些相位"看得清",在另一些相位"看不见"。
三、为什么这件事,跟你今天用 DeepSeek 有关
过去两年,"长上下文"是大模型营销的核心卖点。200K、512K、1M、2M、10M——token 数字越标越大。但没有一家厂商告诉你:这些长上下文里,藏着一个"周期性弱点"区间。
字节 Seed 这篇论文等于替整个行业撕开了这层纱:
- 你之前以为 DeepSeek 抽风是概率事件——其实它是周期性的。同一段信息,落在"倒霉相位"上,10 次问 5 次会错;落在"幸运相位"上,10 次问 9 次都对。你没办法预测,但你可以感知到——"为什么我换个问法它又能答上来"。
- 你之前以为换模型能解决——其实所有用 chunked 压缩的模型都有这个问题。DeepSeek-V4 有、V4.1 有、字节 Seed 从零预训练的所有变体都有。这意味着 Kimi、文心、豆包这些走同样技术路线的国产模型,全部存在相位敏感性。
- 你之前以为升级 Pro、加钱、换节点能解决——其实不能。这是模型架构层面的结构性问题,不是服务质量问题。给你的后端节点再怎么升级,你的内容落在倒霉相位,照样答错。
更狠的是论文里那句警告:"high average accuracy can coexist with systematic positional failures"——高分模型和系统性位置性失败,可以同时存在。你看到的厂商跑分 95+,跟你实际用的感受,可能是两件事。
四、字节 Seed 为什么发这篇
这次发声的,不是普通研究者,是字节跳动的 Seed 团队——国内做基础大模型研究最系统的团队之一。
字节在 2026 年的处境并不轻松:
- 2026 年春节前后发布的 Seed 2.0,对标 GPT-5.2 和 Gemini 3 Pro,但综合榜排在全球第八;
- 2026 年 6 月发布的 Seed 2.1,已经被 DeepSeek-V4、Kimi K3、GLM-5.2 盖过;
- 2026 年 7 月,DeepSeek 的 R1 核心研究员郭达雅加入字节 Seed,张一鸣亲自邀请;
- 2026 年 8 月,CEO 梁汝波在公司全员会上承认,Seed 与海外领先模型的差距正在扩大。
这个时候字节 Seed 把一篇直接点名 DeepSeek 底层机制缺陷的论文发到 arXiv,时机很微妙:
- 技术上,这是给整个行业的"善意警告"。phase sensitivity 是所有用 chunked 压缩的模型的通病,发出来等于帮所有人复盘。但因为是字节发的,这事也自带流量。
- 商业上,这是给字节自家下一代模型(Seed 3 / Seed 2.2)做的铺垫。如果字节新一代模型能避免这个相位敏感性,那就是产品差异化卖点——"我们的长上下文,每个相位都准"。
- 公关上,这是给 DeepSeek 的一次"软点名"。直接说 DeepSeek-V4 有这个问题,又保持学术中立姿态——字节其实是在国内大模型排名承压期,把"我们看到了别人看不到的东西"摆出来。
不管动机是什么,对普通用户来说,这篇论文的核心信息非常清晰:你用 DeepSeek 时遇到"明明写过但它忘了"的现象,不是你 prompt 写得不好,也不是你升级没到位,是所有 chunked 压缩的长上下文模型都有这个结构性弱点。
五、这意味着什么——给每个用长上下文模型的人
如果你是个每天拿 DeepSeek 处理 30 页合同、100 行代码、20 段论文的普通用户,这件事对你的影响有三条具体的:
第一,重新校准你对"长上下文"的预期。32K、128K、200K、500K 不是"全部都准"——它们的平均分高,但有结构性相位弱点。你在最关键的几个位置(合同条款、代码 bug 段、论文公式附近)一定要做一次 cross-check——换个位置重问一次,看答案是否一致。
第二,处理关键任务时,主动切分窗口。如果你的 prompt 超过 30 页,把每 30 页左右的内容独立成一个会话;或者在长文档里主动插入分隔符("===== 第 1 节 ====="),让模型知道"这是新的逻辑段"。这一招没办法消除相位敏感性,但可以让你的关键内容不那么巧落在倒霉相位。
第三,开始关注厂商是否解决这个问题。字节 Seed 这篇论文已经把 phase sensitivity 摆到了台面上。下一步值得留意的是:
- 字节自己的下一代模型(Seed 3 系列)是否会用新的压缩策略避免相位敏感性?
- DeepSeek-V5 是否会在 chunked 压缩之外引入"相位感知"的检索机制?
- Kimi K3、文心 5、豆包这些同代国产模型,会不会被这件事倒逼一次底层架构升级?
过去 12 个月,长上下文赛道的关键词是"更长"。从 2026 年 Q4 开始,关键词可能变成"每个相位都准"。
六、这件"行业级诊断"为什么现在才出来
最后值得问一句:字节 Seed 这篇论文是 9 月底挂到 arXiv 上的,为什么 10 月 9 日才被 IT 之家报道出来?
一方面,arXiv 预印本没有同行评审,发布即流通;另一方面,国内科技媒体"挑论文讲"的节奏是有选择性的——不是每篇 arXiv 都会进入中文科技媒体头条。
这篇能进,是因为它命中了三个传播要素:
- 点名 DeepSeek-V4——目前国内讨论度最高的国产模型之一;
- 解释了一个普遍但没人说得清的现象——"AI 抽风"是每个用户都遇到过的;
- 附了完整机制分析——不是单点 bug 报告,是底层架构层面的诊断。
这意味着 2026 年 Q4 的国产大模型叙事,正在从"谁更长、谁更快"转向"谁更稳、谁不抽风"。DeepSeek-V4 引以为傲的长上下文,被字节 Seed 一篇论文点出了结构性问题。Kimi K3、GLM-5.2、Qwen3.8-Max 这些同代模型,理论上都跑不掉——它们要么公开承认、要么悄悄修、要么等下一个季度的产品发布会悄悄换底层。
但作为用户,你不需要等他们改完。从今天开始,处理长文档时多一步 cross-check,比升级任何 Pro 会员都管用。
记住两件事:
- 抽风是结构性的,不是你的 prompt 问题,也不是节点问题;
- 40 个百分点,是 phase sensitivity 在长上下文里能造成的检索准确率最大差距。
你之前以为的"AI 抽风",从今天开始叫"相位敏感性"——而这个新词,是字节 Seed 替你付学费才弄明白的。